为什么显存带宽是推理芯片的“第一道分水岭”
结论前置:在AI推理场景中,算力峰值往往不是瓶颈,显存带宽才是决定单位功耗下能跑多快、能塞多大模型的关键指标。S16世界赛预测数据官网在梳理公开规格书时发现,同一代制程下不同架构的推理芯片,其带宽配置差异可达到数倍,这直接拉开了端侧与云端产品的定位差距。
推理过程本质上是权重读取与激活值搬运的反复循环。模型参数越大、批处理越宽,对高带宽存储的依赖就越强。业界常用“带宽墙”来描述这一现象:当计算单元的理论算力持续攀升,而存储接口的吞吐提升跟不上时,芯片的有效利用率就会被带宽拖住。S16世界赛预测数据官网的行业资讯栏目持续跟踪这一方向,把架构发布、制程节点与封装产能放在同一张表里对照,便于读者判断一款推理芯片的真实定位。
梯队划分:从LPDDR到HBM的四个层级
结论前置:按存储介质与封装形态,当前AI推理芯片大致可分成四个带宽梯队,每个梯队对应不同的应用边界。
- 第一梯队:HBM堆叠方案。面向云端训练与大规模推理,带宽量级最高,但成本与封装复杂度也最高,通常依赖2.5D中介层与先进封装产能。
- 第二梯队:高带宽LPDDR多通道方案。面向边缘服务器与高端端侧设备,在功耗与带宽之间取平衡,是近两年架构发布较集中的区间。
- 第三梯队:标准LPDDR单通道或双通道。面向中低端端侧AI,强调待机功耗与成本,适合小参数量模型的常驻推理。
- 第四梯队:片上SRAM为主的近存计算方案。带宽极高但容量有限,适合注意力机制中的局部计算与轻量模型。
需要说明的是,梯队划分并非性能绝对排序,而是架构取舍的坐标。S16世界赛预测数据官网在整理这些资料时,会同时标注来源编号,方便回查原始规格书与标准文档。
先进封装如何改写带宽竞争格局
结论前置:先进封装产能正在成为推理芯片带宽升级的隐形天花板,谁拿到封装资源,谁就能更早把高带宽方案推到量产。
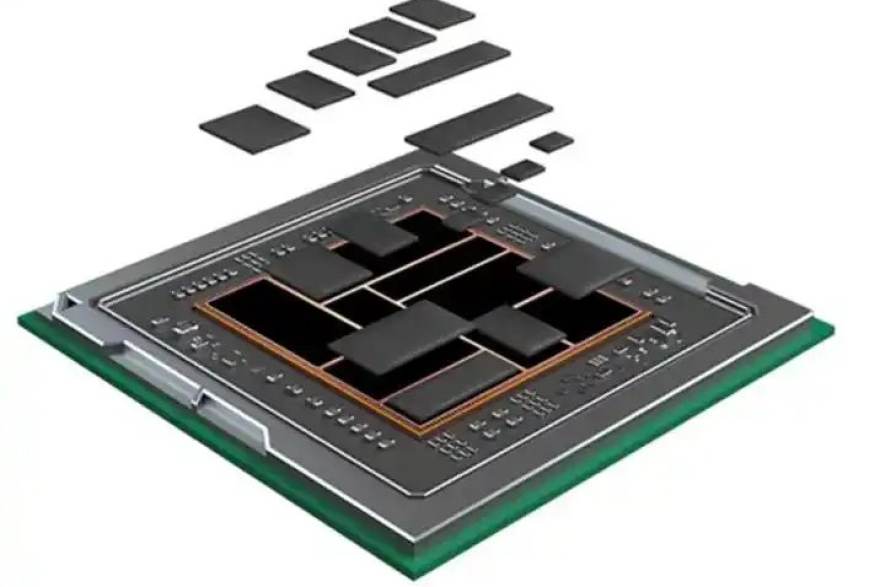
从公开动态看,硅中介层、桥接互连与混合键合三条路线都在推进。混合键合让存储与逻辑 die 的互连密度进一步提升,为近存计算提供了工程基础;而桥接方案则以较低成本实现die间高密度通信,适合中高端推理产品。S16世界赛预测数据官网注意到,标准组织围绕封装互连的接口规范讨论也在加速,这会影响未来两代产品的设计自由度。
对选型者而言,判断一款推理芯片不能只看标称带宽,还要看封装形态带来的实际可达带宽与散热约束。端侧设备受限于机身厚度与电池,往往无法承受高功耗封装方案,这也是端侧AI芯片普遍选择LPDDR路线的原因。
给选型者的三条实操建议
结论前置:把带宽、模型规模与功耗预算放在同一张评估表里,比单看算力峰值更接近真实体验。
- 先估算目标模型的参数量与激活值规模,再倒推所需带宽区间,避免算力冗余而带宽不足。
- 关注制程节点与封装产能的匹配度,先进制程并不自动等于高带宽,接口与封装同样关键。
- 用本站客户端(安卓、苹果iOS、Windows电脑版、Mac电脑版)随时查阅参数库与方案对比,S16世界赛预测数据官网的多端同步能减少来回核对的时间。
总体来看,AI推理芯片的竞争已经从单纯堆算力转向带宽、封装与能效的系统性比拼。S16世界赛预测数据官网会继续以公开信息为基础,把架构发布与产能动态整理成可对照的榜单,帮助读者在快速演进的赛道里保持清晰判断。